性能压测报告(2026-09)
测试日期:2026-09-23/24 · 测试版本:v0.13.0 预览版(受控测试统一构建,提交
484204ff;生产观察机为同期预览系构建) 数据性质:厂商自测。方法与判定口径全文公开,可按第 8 节说明在同类硬件上复现。
1. 背景与目的
NVR 行业目前缺少有明确测量条件的公开性能数据:跨产品的第三方压测不存在,能查到的要么是官方自述的局部指标(如 detector 推理耗时),要么是没有标注硬件、码率、帧率等条件的编辑估算表,无法相互比较。
本报告为 MiBeeNvr 补一份自测数据,目标不是与其它产品比高低(没有可比较的公开口径),而是把「不同硬件档位上 MiBeeNvr 自身的容量与资源曲线」测量并公开,供选型与复现参考。为便于日后与社区通用的容量规划方法对照,负载同时折算了 MP/s(见 3.3)。
2. 测试环境
| 设备 | 角色 | 处理器 | 内存 | 存储 | 部署 |
|---|---|---|---|---|---|
| Banana Pi M5 | 生产机(只读观察) | Amlogic S905X3,ARMv8 ×4 | 4GB | 2.7TB SATA | 裸机 systemd |
| RK3399 NAS | 受控压测(低配档) | RK3399 ×6 | 4GB | eMMC 级存储卷 | fnOS + Docker |
| x86 工作站 | 受控压测(高配档) | i5-12600KF,10C16T | 64GB | NVMe | 裸机 |
| x86 笔记本 | 流量生成 / 空载测量 | 8 核 | 16GB | SSD | — |
RK3399 NAS 的存储卷为 eMMC 分区上的单成员 RAID1 + 精简配置卷,写入放大 2 倍——这个细节在后文数据里反复出现,是理解该档位结果的钥匙。生产机在测试窗口内恰逢一次历史录像归档迁移,因此拿到了同一台设备的「高 IO 压力」与「常态」两个观察窗。
3. 方法
3.1 负载与测量
- 合成摄像头:预渲染 MP4 按
-re实时 pacing 经 RTMP 接入推流,两种规格——1080p25 H.264 2.5 Mbps(GOP 2s、无 B 帧)与 4K25 H.264 16 Mbps。推流端带断线重连,行为对齐真实摄像头。逐路口径:NVR/api/streams计数器每 30 秒快照,核对每路入口码率。 - 资源采样:Linux 端 5 秒间隔读取
/proc/stat原始计数器(可分解 CPU 占用与 IO 等待)、/proc/meminfo、NVR 进程 RSS;Windows 端同节奏性能计数器。磁盘实测以 iostat 为准。 - API 探针:5 秒间隔请求
/api/health(公开路径)与/api/recordings?limit=5(鉴权 + SQLite 查询路径),记录完整延迟分布与失败数。 - 观看端:FLV / LL-HLS / RTSP 三协议真实拉流客户端并发观看,统计吞吐、首字节、直播边缘时延(LL-HLS 依 playlist 的 PROGRAM-DATE-TIME 计算)。
3.2 判定口径
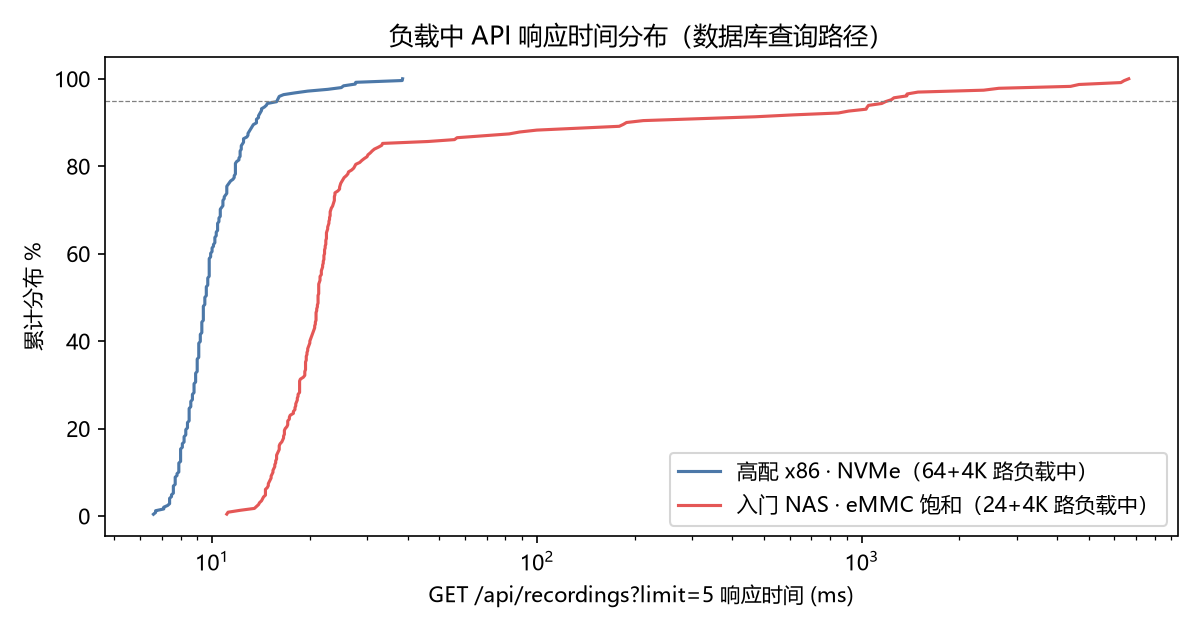
CPU 占用含软中断,IO 等待单列;「稳态窗口」= 最后一台推流器启动 60~75 秒后开始的 4 分钟;表格内 API 延迟取稳态窗口分位数。所有曲线均有逐 5 秒原始数据。
配置口径:除 6.4 节的对照实验外,全部测试使用出厂默认配置——storage.durability 为默认 strict 档(每段录像 finalize 时 fsync,最强持久化)、io.budget_bytes_per_sec 为默认 0(后台 IO 预算关闭)、预分配开启。即本报告主体数据是默认姿态下的实测,不含任何需要手动打开的优化开关。
3.3 负载换算(MP/s)
按社区容量规划惯用的 MP/s 量纲折算:1080p25 = 51.8 MP/s/路,4K25 = 207.4 MP/s/路。本次 x86 峰值 68 路 ≈ 4,145 MP/s,RK3399 纯转发 30 路 ≈ 1,555 MP/s。注意:MiBeeNvr 录制为压缩域直存、不解码,此处的 MP/s 表示吞吐量纲,可与通用方法对照,不能直接等同于解码型负载。
4. 空载足迹与启动
笔记本上零相机空实例,36 分钟观察(432 个采样点):
| 指标 | 实测 |
|---|---|
| 发行物 | 单个静态二进制 67 MB(CGO=0,内嵌 Web UI,无运行时依赖) |
| 冷启动 → API 就绪 | 10 次实测 115~184 ms,中位 122 ms |
| 空载内存(RSS) | 37.3~38.8 MB |
| 空载 CPU | 0.0% |
RK3399 NAS 容器(已注册 24 路国标相机、录像库万余行):docker start → API 就绪 1.46~1.59 s;容器优雅退出需 1.5~6.3 s(数据落盘)。
5. 高配 x86:录制阶梯与并发观看
从 16 路逐级加至 68 路(64×1080p + 4×4K),每级稳态 3 分钟,每路口径 2.5/16 Mbps 全程精确保持:
| 负载 | 入口总码率 | 整机 CPU(16T) | NVR 进程内存 | health p50/p95 | recordings p50/p95 |
|---|---|---|---|---|---|
| 基线(1 路真实相机) | 2.0 Mbps | 11.4% | 57 MB | — | — |
| 16×1080p | 42.2 Mbps | 12.8% | 82 MB | 8.5 / 15.2 ms | 9.4 / 38.5 ms |
| 32×1080p | 82.3 Mbps | 14.3% | 105 MB | 8.9 / 14.5 ms | 9.0 / 14.0 ms |
| 48×1080p | 122.4 Mbps | 15.3% | 131 MB | 9.6 / 16.7 ms | 9.6 / 12.5 ms |
| 64×1080p | 162.4 Mbps | 19.7% | 156 MB | 10.6 / 18.2 ms | 10.1 / 22.7 ms |
| 68 路(含 4×4K) | 226.5 Mbps | 24.2% | 171 MB | 8.7 / 15.0 ms | 11.1 / 27.6 ms |
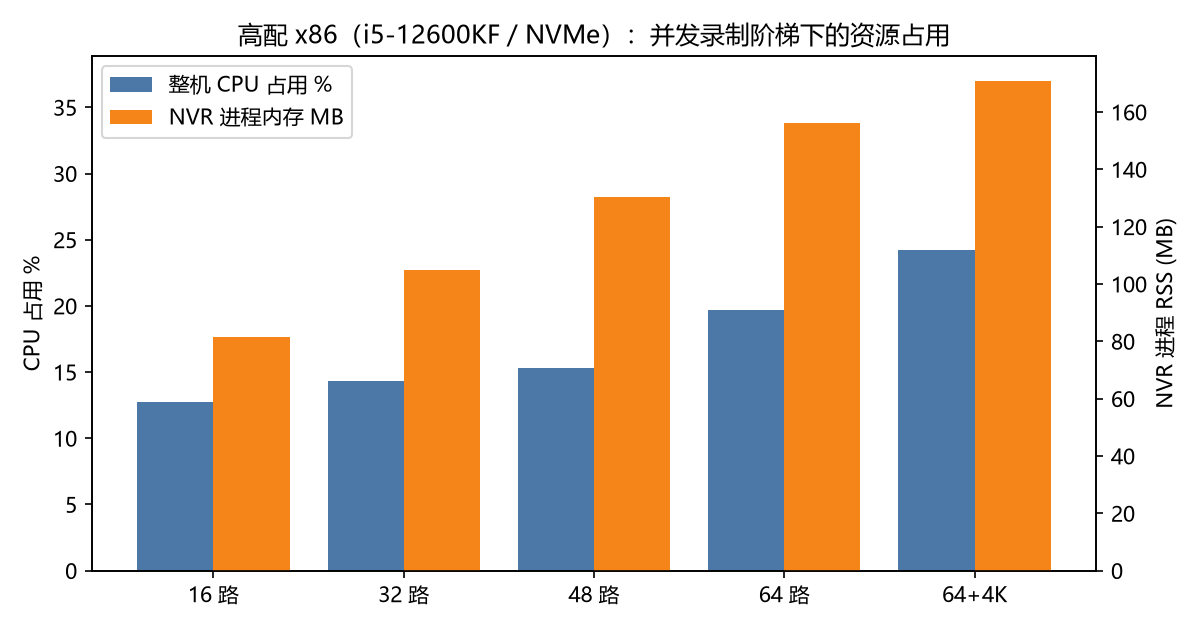
观察:每增一路 1080p 约 +3 MB 内存;CPU 斜率约每 40 Mbps 增 2 个百分点(16 线程口径)。API 探针全程 0 失败(32 路并发观看阶段同样为 0),测试结束后 health 恢复 1.2~1.9 ms。本档止步 68 路是流量生成端到达上限,非 NVR 侧出现异常。
满负载(68 路录制)之上叠加 32 路并发观看(12 FLV + 12 LL-HLS + 8 RTSP,持续 5 分钟):
| 协议 | 结果 |
|---|---|
| FLV | 12/12 会话 200,每路 2.50~2.51 Mbps 精确满速;首字节 min/p50/p95 = 65/167/256 ms |
| LL-HLS | 12/12 正常供流;起播 min/p50/p95 = 438/1414/2095 ms;直播边缘时延中位 1.3 s |
| RTSP | 8 路三轮拉流,0 错误 |
6. RK3399 NAS:三种工作档位
6.1 录制阶梯(8 → 28 路,20 → 124 Mbps)
| 负载 | CPU 占用 | IO 等待 | NVR 内存 | health p50 | recordings p50 |
|---|---|---|---|---|---|
| 8×1080p(20 Mbps) | 20.1% | 59% | 130 MB | 24 ms(后期进入饱和) | 20 ms |
| 16×1080p(40 Mbps) | 20.0% | 73% | 162 MB | 2.0 s | 22 ms |
| 24×1080p(60 Mbps) | 22.6% | 72% | 203 MB | 2.0 s | 22 ms |
| 24×1080p+4×4K(124 Mbps) | 19.7% | 73% | 197 MB | 2.0 s | 22 ms |
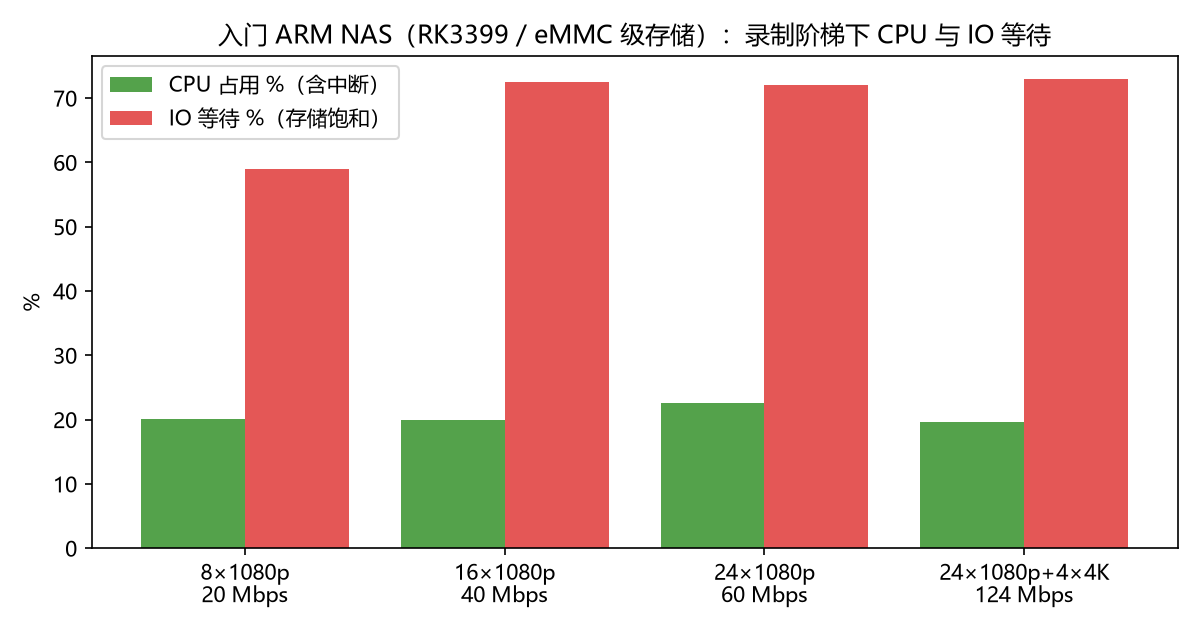
CPU 曲线在 20~23% 处走平,NVR 进程单核峰值 41.8%。饱和点在存储:iostat 显示卷设备 100% 利用率、写等待 3.4~6.9 s、实际写入约 6~7 MB/s(含 RAID1 写放大)。饱和后的行为分层:
- 录像与逐路口径不受影响(每路码率保持、分段照常落盘);
- 录像查询(SQLite 读路径)不受影响,p50 全程 20~22 ms;
- health 检查退化到 2 s——其内部有一次面向存储卷的 statfs,在设备饱和时阻塞,可作为「存储在喘气」的信号灯读;
- 极端饱和下的观看(第二轮验证):LL-HLS 8/8 客户端拿到数据但起播最长 88 s、直播边缘 35~53 s;RTSP 正常出流;FLV 新会话 15 s 内无法建立(健康态实测 106~135 ms)。
负载撤除后的恢复曲线(health p50 / 同时段 max):+0~1 分钟即回到 17~23 ms,但背景 IO 使个别请求仍达 2 s 约 6 分钟,之后 max < 31 ms,全程无崩溃、无进程重启。
6.2 干净低载档(4 路录制,10 Mbps)
| CPU | IO 等待 | NVR 内存 | health p50/p95 | recordings p50/p95 |
|---|---|---|---|---|
| 16.7% | 44% | 77 MB | 24 ms / 1485 ms | 21 ms / 188 ms |
10 Mbps 录制即出现个别的 statfs 尖峰——再次说明该档位的瓶颈完全在 eMMC 卷本身,而非 CPU 或软件。
6.3 纯转发档(30 路直播、不落盘,75 Mbps)
将 30 台相机设为 live-only(recording_enabled: false):
| CPU | IO 等待 | NVR 内存 | health p50/p95/max | recordings p50/p95 |
|---|---|---|---|---|
| 30.5% | 15% | 95 MB | 21 ms / 40 ms / 62 ms | 21 ms / 30 ms |
写入路径退出后,30 路入口 + 分发下 API 分布完全干净;对 live 相机拉 FLV:200、2.52 Mbps、首字节 135 ms。该档位说明 RK3399 作为纯直播网关(预览/级联/转推场景)有充分余量,约 1,555 MP/s 吞吐只用了三成 CPU。
6.4 刷盘策略开关对照:storage.durability strict vs relaxed
durability 决定裸段录像的 fsync 策略(#760):默认 strict 每段 finalize 都 fsync;relaxed 跳过主动 fsync、交给文件系统提交间隔(断电可能丢最后几秒裸段录像,合并/延时产物不受影响,官方定位是闪存板受益最大)。为量化该开关在慢存储上的实际收益,在 RK3399 NAS 上做了同负载、同背景(滚动合并后台任务均在运行)的配对测试:
| 档位 | durability | health p50 / p95 | IO 等待 | CPU | NVR 内存 |
|---|---|---|---|---|---|
| 16×1080p(40 Mbps) | strict | 2024 / 3045 ms | 72.5% | 20.0% | 162 MB |
| 16×1080p(40 Mbps) | relaxed | 2019 / 2027 ms | 73.2% | 21.1% | 171 MB |
| 24×1080p(60 Mbps) | strict(首轮) | 2022 / 2033 ms | 72.0% | 22.6% | 203 MB |
| 24×1080p(60 Mbps) | strict(配对复测) | 2020 / 2035 ms | 68.4% | 24.9% | 217 MB |
| 24×1080p(60 Mbps) | relaxed | 2023 / 2040 ms | 54.7% | 31.7% | 131 MB |
写路径的瞬时指标确有改善:strict 稳态下卷设备写等待 3.4~3.9 秒、利用率持续 100%;切 relaxed 后写等待降到 0.2~0.3 秒,设备利用率从「持续饱和」变为「突发型」。但从整窗统计看,该设备的 health 延迟与饱和阈值没有变化——原因在于这台 NAS 的存储压力是多个来源叠加的(单成员 RAID1 的 2 倍写放大、滚动合并的后台批量 IO、系统自身的后台读),去掉录像 fsync 只是把持续压力改为突发压力,不足以把设备拉回非饱和区。
结论:在 eMMC 级慢存储上,relaxed 能让写排队更平滑(对掉电可容忍的部署是个合理选项),但不能改变这类存储的容量上限;在 NVMe 等快存储上(第 5 节)默认档位本就不构成瓶颈,无需打开。本节同时说明:主报告各节均在默认 strict 档下测得,没有借助该开关修饰数字。
附注:对照实验过程中,该容器的一次 docker restart 遇到运行时僵死(docker ps 报 Up 而进程已不存在,stop/start 后恢复;进程退出前的日志无 panic、内核无 OOM 记录,属宿主环境事件而非 NVR 崩溃)。该事件导致 SQLite 未检查点落盘的推流键丢失(相机与录像数据完好),重建后继续测试——生产部署建议以正常方式(systemd / 应用商店)而非 docker restart 直接重启。
7. ARM 单板生产机:两个观察窗
Banana Pi M5(S905X3 ×4 / 4GB / 2.7TB SATA),18 路真实相机(ONVIF / GB28181 / 小米 / MJPEG 混合),7×24 运行,盘上已积累 2.1TB 录像(单相机最高 467 GB / 2014 段)。只读观察,未做任何变更:
| 指标 | 常态窗(14 分钟) | 高 IO 压力窗(46 分钟)¹ |
|---|---|---|
| health p50 / p95 / max | 12.2 / 25.3 / 1015 ms | 13.5 / 53 / 2232 ms |
| recordings p50 / p95 | 252 / 306 ms | 253 / 338 ms |
| 入口码率 / 活跃路数 | 16.1 Mbps / 12 | 17.9 Mbps / 12 |
| NVR 进程 RSS(min/avg/max) | 182 / 267 / 414 MB | 114 / 194 / 412 MB |
| SoC 温度(avg / max) | 51.2 / 54.5 ℃ | 52.6 / 58.3 ℃ |
| 整机 CPU(含 IO 等待折算) | 20.1% | 34.5%(iowait 占大头) |
¹ 观察窗内该机正在执行历史录像归档迁移,磁盘 IO 等待约 80%;NVR 进程自身约占半个核,录像持续。
同一台 SATA 盘设备在 80% iowait 下 health p50 仍 13.5 ms,对照第 6 节 eMMC 卷同样压力下的 2 s,两者差两个数量级——存储介质决定低配档的体验上限,这一结论在生产环境得到复现。recordings 查询 250 ms 级与其 2.1TB/数万行的库规模相符。
8. 未覆盖项与复现说明
未覆盖:软件转码规模(H.265→H.264 软转码是 CPU 密集路径,生产建议以子码流直录规避)、WebRTC 端到端时延(依赖浏览器端测量)、万兆网络、云归档吞吐、音频轨、io.budget_bytes_per_sec 后台 IO 预算(默认关闭;本测试窗口内后台合并负载固定存在,未单独 A/B,见 6.4)。合成流为纯视频。
复现:第 3 节的负载规格(合成流参数、 pacing、重连行为)、采样节奏与判定口径完整公开,在同类硬件上按同样口径搭建即可复现同类曲线。同硬件跨产品对照(如同机同负载的其它 NVR)目前在行业内亦无第三方公开数据,属于后续可补的对照项。
MiBee 团队,2026-09-24。全部数字为自测值,测量条件见第 3 节。